공개 서열에서 얻은 더 나은 예측
AI3 Discovery
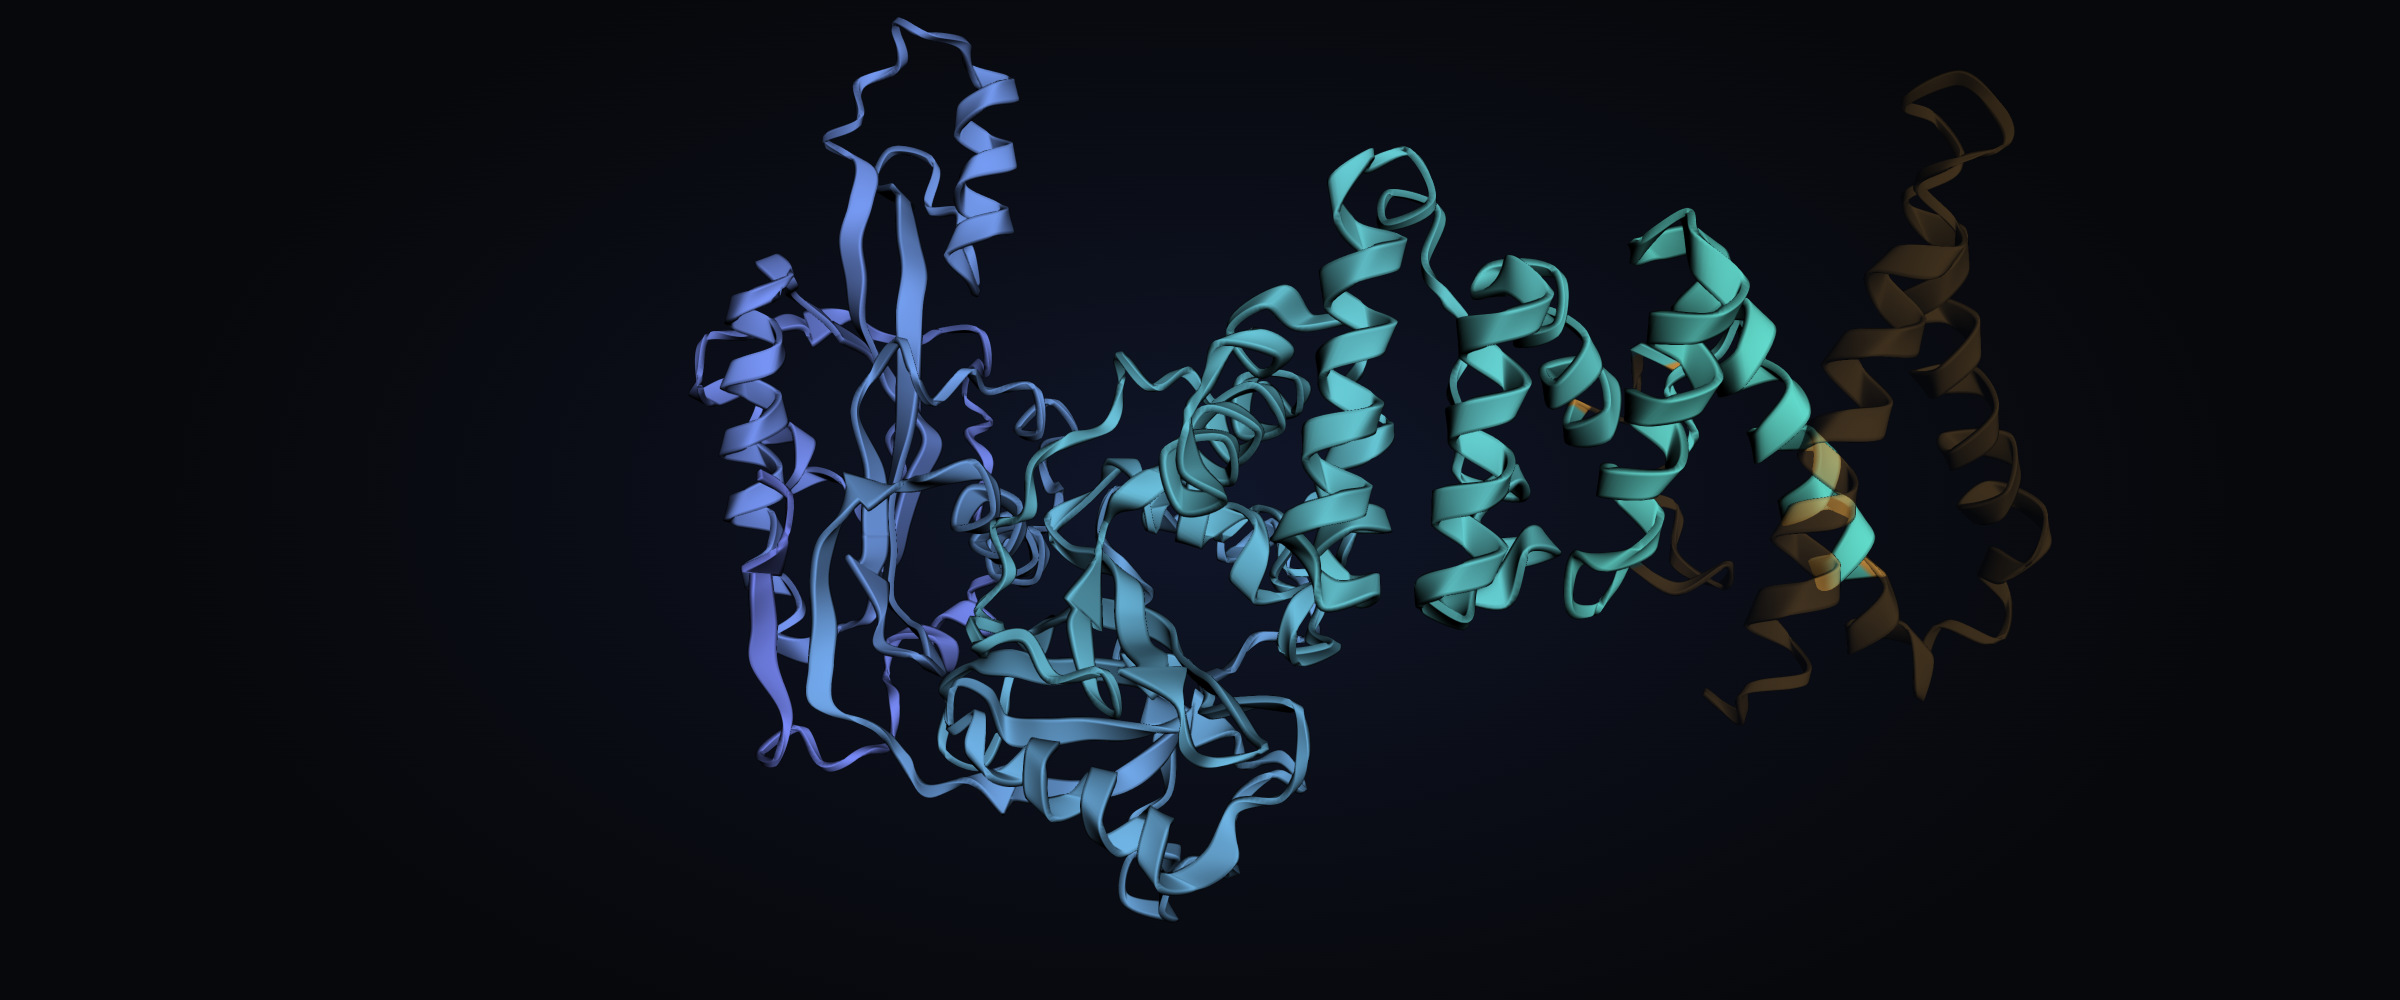
대표 이미지: ART_69 파트너의 AlphaFold2 예측 구조이며 실험 구조가 아닙니다. 황색은 신뢰도가 낮은 잔기를, 나머지 색의 흐름은 서열 위치를 나타냅니다. 색이 도메인 경계를 뜻하지는 않습니다.
공개 정렬만 넣었을 때 낮은 신뢰도로 예측되던 ART 파트너 단백질이, 공개 메타게놈에서 찾은 상동 서열을 보충하자 훨씬 높은 신뢰도로 예측됐습니다. LPJP1의 P2 파트너에서 AlphaFold2 평균 pLDDT는 38–47에서 80–83으로 상승했습니다. 같은 수의 패밀리 행을 유지한 채 각 행의 잔기를 섞으면 35로 내려갔습니다.
이번 연구의 출발점이자 가장 분명한 결과입니다. 자료가 부족해 잘 예측되지 않던 단백질에서, 공개 서열을 찾아 입력 정렬을 보강하고 예측 신뢰도 상승을 대조군과 함께 확인했습니다. 낮은 신뢰도가 단백질 자체의 성질만을 반영하는 것은 아니라는 것을 이 사례에서 보여줍니다.
그다음 질문은 더 까다로웠습니다. 신뢰도가 올라간 예측 구조를 읽으면 단백질의 접힘도 명확히 판단할 수 있을까요? 같은 모델을 구조 검색, 서열 프로파일, 구조 패널로 읽자 서로 다른 답이 나왔습니다. 우리는 예측을 개선하는 작업과 그 예측에서 생물학적 결론을 내리는 작업을 나누어 시험했습니다.
무엇을 확인했나
공개 데이터로 입력 정렬을 보강할 수 있었다
ART 파트너처럼 기능이 충분히 알려지지 않은 단백질에서는 자동 정렬 서버가 돌려준 서열만으로 분석을 끝내기 쉽습니다. 우리는 공개 Logan 데이터로 돌아가 상동체를 찾고, 이 서열들을 기존 정렬에 보충했습니다. 그 결과 LPJP1 파트너의 상당 부분에서 예측 신뢰도가 높아졌습니다. 다만 N 말단처럼 끝내 낮은 신뢰도로 남은 영역도 있었습니다.
이는 모든 단백질에 통하는 성능 개선법을 입증한 결과는 아닙니다. 정렬 깊이가 중요하다는 일반 원리를 새로 발견한 것도 아닙니다. 기여는 이번 ART 표적에서 기본 서버 정렬만으로는 얻지 못했던 예측 신뢰도를 공개 데이터의 추가 서열로 확보하고, 대조군과 여러 판독법으로 그 효과와 해석 범위를 검토한 것입니다. 실험 구조를 확보하지 않았으므로 예측 신뢰도 상승을 실제 구조 정확도의 증명으로 해석하지는 않습니다.
단순히 행 수를 늘린 효과와 구분했다
정렬을 보강한 뒤 점수가 올랐다는 사실만으로는 충분하지 않습니다. 입력 행이 많아져서 생긴 효과인지, 그 행들이 담고 있는 서열 정보가 중요했는지 확인해야 합니다.
그래서 행 수, 갭, 잔기 조성을 유지하되 각 패밀리 행 안의 잔기를 섞은 정렬로 같은 예측을 수행했습니다. 실제 서열을 넣었을 때의 상승은 섞은 행에서는 재현되지 않았습니다. 추가한 서열의 내용이 중요했다는 해석을 지지하는 대조 결과입니다. 다만 이 대조는 서열 보존성과 공변이를 구분하지 못하므로, 올바른 공진화 정보를 확보했다고까지 주장하지는 않습니다.
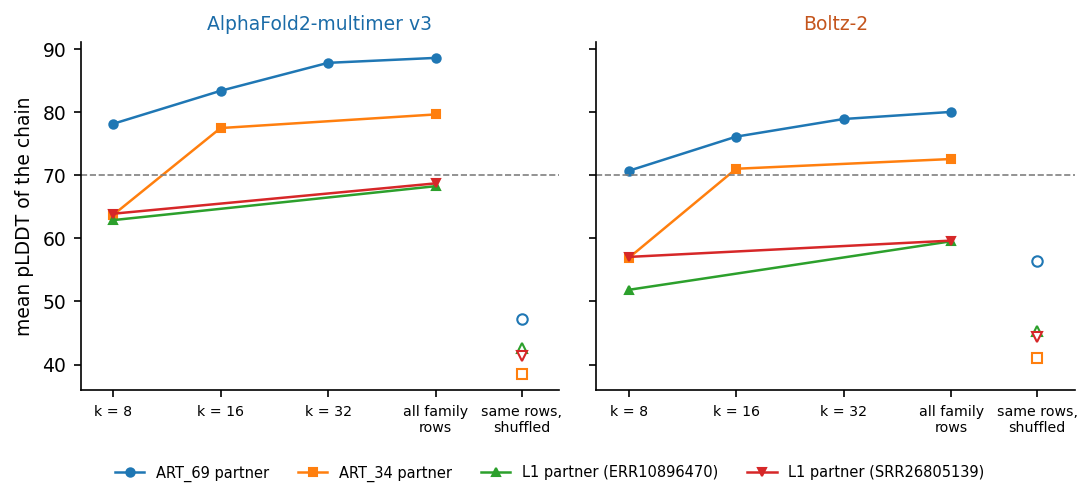
상동 서열 보충과 대조 정렬의 차이. 다른 ART 좌위의 파트너 분석에서도 실제 패밀리 행과 섞은 행을 비교했습니다. 채운 기호는 실제 서열, 빈 기호는 같은 행을 섞은 정렬의 결과입니다. 예측 신뢰도를 개선한 범위와 여전히 개선되지 않은 범위를 함께 보여줍니다.
신뢰도 높은 예측에서도 판독법의 차이를 확인했다
추가로 분석한 ART_69 파트너의 AlphaFold2 평균 pLDDT는 88.4–88.8였고 체인 대부분이 높은 신뢰도로 예측됐습니다. LPJP1의 미해상 영역만 보고 연구를 끝내지 않고, 더 잘 예측되는 다른 파트너에서도 판독을 비교한 이유입니다.
결과는 일치하지 않았습니다. 추가 파트너에서 Foldseek은 GNAT 유사 피크를 하나 받아들였고, Pfam GNAT 클랜 모델은 히트를 내지 않았으며, 구조 패널은 사전 지정한 두 영역 기준으로 GNAT 유사 윈도 두 개를 찾았습니다. 윈도 두 개는 서로 맞닿아 있어 도메인 두 개인지 긴 영역 하나인지 가르지 못했습니다.
예측 신뢰도와 도메인 판정은 별개의 문제라는 점을 구체적인 표적에서 확인했습니다. 이 결과는 기능 실험의 표적이나 변이 구간을 정할 때 검토할 계산 자료를 제공하지만, 실험 없이 GNAT 도메인 수나 효소 활성을 확정하는 근거는 아닙니다.
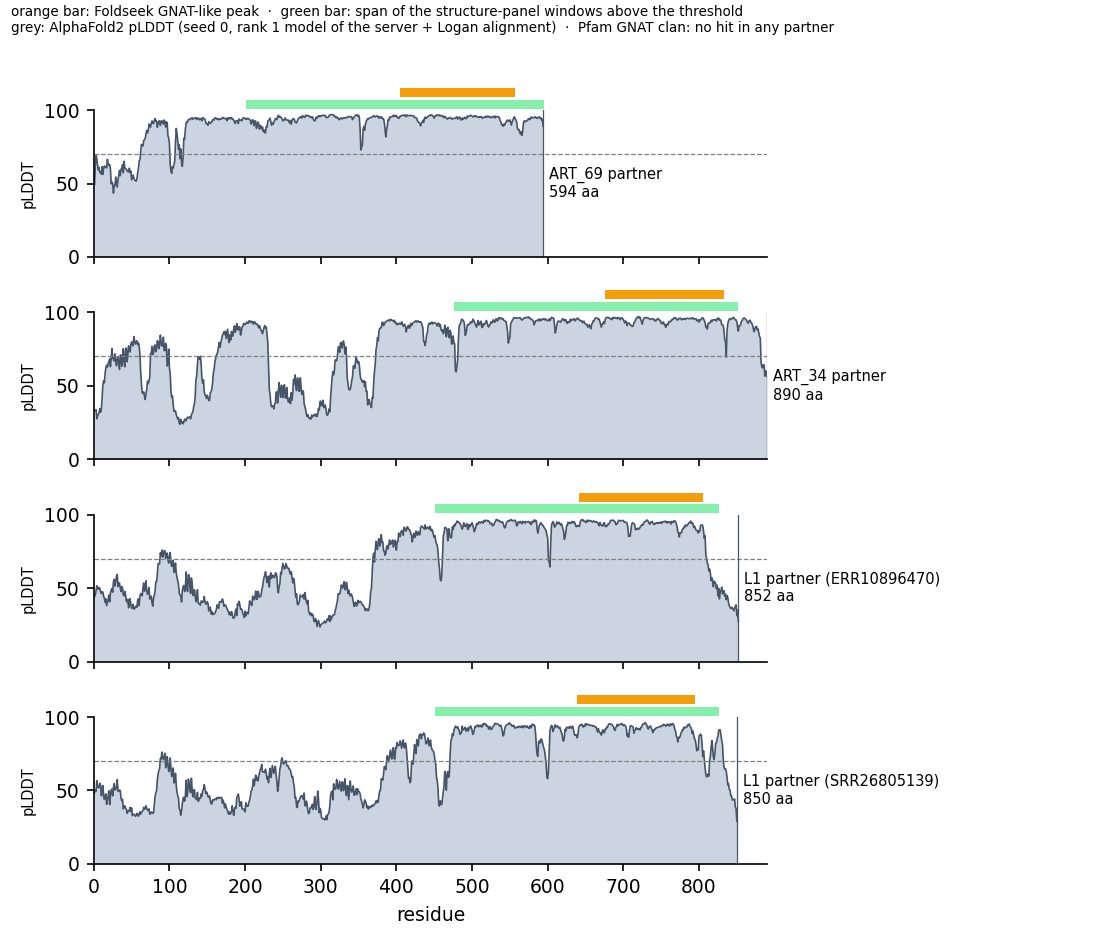
같은 단백질에서 서로 다른 판독이 가리키는 구간. 회색은 예측 신뢰도, 주황은 Foldseek 피크, 초록은 구조 패널 윈도의 범위입니다. ART_69에서는 체인 대부분이 높은 신뢰도로 예측되지만, 판독법들이 같은 영역을 동일하게 분류하지는 않습니다.
연구의 범위
Listeria 파지 LPJP1의 두 파라로그 파트너, 상동체 91개 체인의 패밀리, 다른 ART 관련 좌위에서 확보한 완전한 파트너 4개를 분석했습니다. AlphaFold2와 Boltz-2에 정렬을 입력하고, Foldseek·Pfam 클랜 모델·이름에 의존하지 않는 구조 패널로 결과를 읽었습니다. 알려진 GNAT 단백질과 비GNAT 단백질, 깊이를 맞춘 정렬, 행을 섞은 정렬을 대조로 사용했습니다.
패밀리의 탐색적 두 번째 영역 점수는 채점 가능한 체인 71개 중 55개에서 기준을 넘었습니다(전체 91개 기준으로는 55개). 추가 파트너에서는 사전 지정한 두 영역 기준을 모델 24개가 충족했습니다. 다만 세 시드 전부를 쓴 모델 집합은 결과를 읽은 뒤에 기록했고, 모델들은 3개 계통의 정렬을 공유하므로 독립된 관찰로 세지 않았습니다.
이 연구는 앞서 공개한 ART 좌위 재현 기록과 별개입니다. 재현 연구가 유전자와 배열의 위치를 찾는 작업이었다면, 이번 연구는 확보한 파트너 서열의 구조 예측을 보강하고 판독 결과를 검토하는 작업입니다.
AlphaFold 3를 사용하지 않은 이유
이번 연구 당시에는 AlphaFold 3의 공식 모델 가중치를 확보하지 못했습니다. 공개 가중치의 이용 조건은 기관과 사용 목적에 따른 자격을 별도로 제한합니다. 이는 코드의 오픈소스 라이선스와 다른 조건이며, 모든 상용 이용 경로가 금지된다는 뜻은 아닙니다. 현재 공식 안내에는 별도의 상용 클라우드 경로도 있지만, 이번 분석에는 도입하지 않았습니다.
이 연구는 AlphaFold2와 Boltz-2 안에서 같은 표적의 입력 정렬을 바꾸고 대조군과 비교한 결과입니다. AlphaFold 3를 시험하지 않았다고 그 비교가 무효가 되지는 않습니다. 다만 AlphaFold 3로 미해상 영역이 더 잘 예측되거나 구조 판독이 달라질 가능성은 남아 있습니다. 저신뢰·미해상이라는 서술은 시험한 예측기와 설정에 한정하며, 최신 예측기로도 해결되지 않는다는 주장으로 확대하지 않습니다. 그 가능성을 판단하려면 AlphaFold 3 자체와 적절한 대조군을 별도로 시험해야 합니다. 예측 신뢰도와 검출 기준도 AlphaFold 3의 대조군에서 다시 확인해야 하며, 기존 엔진의 판정 하한을 그대로 옮겨 쓰지 않습니다.
무엇을 아직 판단하지 못했나
원 연구진의 구조 분석 사례는 ART_57이었으며, 그 접근번호를 확보하지 못해 직접 분석하지 못했습니다. 따라서 이번 결과를 그 특정 사례에 대한 직접 재현이나 반박으로 소개하지 않습니다. 우리가 분석한 것은 공개 서열을 확보한 다른 파트너와 그 상동체입니다.
구조 예측을 보강한 결과와 판독법 간 불일치는 확인했지만, GNAT 도메인 개수와 효소 활성은 미판정으로 남았습니다. 후속 기능 실험으로 넘어갈 계산 근거는 마련했지만, 그 실험을 대신한 것은 아닙니다. 예측기들이 입력 정렬을 공유하는 점, 대조군과 표적의 정렬 깊이·영역별 커버리지가 다른 점 등도 원고에서 구분했습니다.
원고와 검산 자료
| 연구 원고와 데이터 |
|---|
| 영문 정본 PDF · 한글판 PDF · Zenodo 검산용 데이터. 자체 공개한 연구 원고이며 사람의 독립적인 동료 심사를 거치지 않았습니다. Zenodo에 함께 들어 있는 PDF는 2026-10-03 판이고, 여기 연결한 PDF가 최신 정정본입니다. |
공개 전에 별도의 AI 검토·검산 세션으로 원고를 분석 기록과 대조하고, 주요 수치를 보존된 예측·결과 파일에서 다시 계산했습니다. 이 검산은 구조 예측을 새로 독립 수행한 것은 아니며, TM-align의 윈도별 점수 계산 자체도 다시 실행하지 않았습니다. 실제 검산한 범위와 미검산 범위를 구분해 기록했습니다. 외부 사람의 감사나 독립적인 동료 심사는 아닙니다.
단백질 서열·정렬·예측 모델·결과 표는 Zenodo에 CC BY 4.0으로 공개했습니다. 분할 압축파일을 다시 합치고 해시를 확인하는 방법은 보충자료의 README에 있습니다. 이번 정정으로 연구 데이터 파일은 바뀌지 않았습니다. 분석 코드, 보정한 관문 파일, 탐침 모델, 하네스 모듈, 사전 지정 문서의 본문은 공개하지 않습니다.
| 파일 | 쪽수 | 바이트 | SHA-256 |
|---|---|---|---|
| EN PDF | 22 | 943,654 | 460d150701fc3d76994e9444221711bc070f6c0696b388f2b8e18e2c5c8cb5e4 |
| KO PDF | 19 | 1,455,965 | c11392c2b22169556c811e17f281e512f0d1b0c9afcab31e94e9a25bfb914cb8 |
출처와 연구 하네스
Yoon PH, Athukoralage JS, Ameisen E, Kauderer-Abrams E, Perry NT, Durrant MG. Autonomous AI agents discover reverse transcriptases with tandem repeat arrays. 원 연구 원고. ART 최초 발견의 공로는 원 연구진에게 있습니다.
연구 하네스와 AI 활용. 이번 연구에는 AI3 Discovery의 과학 연구 하네스를 사용했습니다. AI 코딩·분석 에이전트와 함께 공개 서열 탐색, 정렬 보강, 예측, 대조군 분석, 근거 확인을 연결했습니다. 자동 점검과 AI 검토가 사람의 동료 심사를 대신하지는 않습니다. 공개한 글의 내용에 대한 책임은 AI3 Discovery에 있습니다.
| AI3 Discovery와 함께 연구할 연구자·연구실을 찾습니다 |
|---|
| 공개 데이터에서 계산 근거를 만들고 이를 실험으로 이어갈 연구자와 연구실의 연락을 기다립니다. 탐구하고 싶은 질문, 분석할 데이터, 계산과 연결할 실험 방향이 있다면 함께 이야기해 보세요. 공동연구·데이터 문의: [email protected] |